Role 01 / BUILD
Agent 制造员
把一件重复活儿拆清楚,做成能稳定干活的 Agent——提示词、工作流、脚本、模型,都算零件。
拆解 → 定义 → 稳定交付
About · Self-introduction · 2026
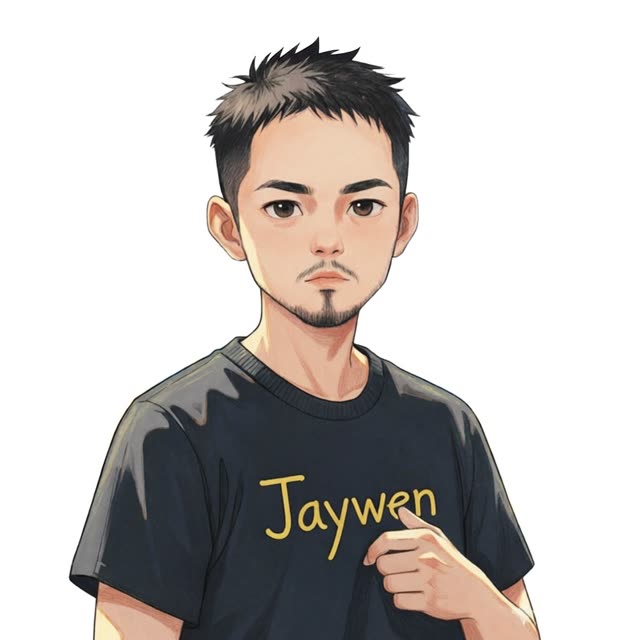
Hello,我是 jaywen,中文笔名百文不如一建。设计出身,一路往两边铺:UI 和平面负责好看,前后端负责真能跑,短视频从拍到剪,现在大半时间在 AI 里——LLM、开源模型本地部署、Stable Diffusion 的 WebUI 和 ComfyUI,还有换脸这类深度伪造。
Agent / 组织形态 / 能力模型
我越来越相信:以后一个要持续产出东西的团队里,Agent 的数量会比人多。
人不多,但每个人身后都带着一队 Agent。这几年我已经习惯把这些活儿先交给自己的 Agent 跑一遍——找参考、批量出图、粗剪、按尺寸导出。以前一套物料要磨一整天,现在它先把脏活干完,我只管判断哪张能用。
Role 01 / BUILD
把一件重复活儿拆清楚,做成能稳定干活的 Agent——提示词、工作流、脚本、模型,都算零件。
拆解 → 定义 → 稳定交付
Role 02 / DRIVE
决定它往哪跑,看产出判断它跑得对不对,跑偏了自己接管。
定方向 → 判产出 → 接盘
设计 / 开发 / 影像 / AI
我很少只干一件事。准确说,是每件事都干到能自己收尾的程度——设计稿能自己切成页面,页面能自己接上接口和数据库、自己挂到服务器,片能自己拍完剪完,模型能自己拉下来跑通。
每个间距、每档字号,都是制造 Agent 的输入。
前端只是壳。数据、接口、部署都通,才算能跑。
从分镜到成片,驾驶 Agent 也靠它。
这一块既用来制造也用来驾驶:搭工作流是制造,调参、比图、判断能不能用是驾驶。后三项是现在落得最多的场景——AI 提效(原来要人做一天的活)、AI 自动化(原来要人盯着跑的流程)、Agent Skill(把一套判断写成能被调用的能力)。
换脸这类技术我只放在授权与合规的场景里用——本人同意的数字人、影视预演、去标识化测试;不碰别人的脸。
两套翻译 / 中间不换手
这些年我反复在做的事,其实就一句话:把脑子里的一个想法,翻译成别人能打开、能用、能看懂的东西。这件事要过两道翻译,每道都会掉信息。
Source
脑子里的想法
模糊的、说不清的那句
System 01
翻译成看得见的
界面、排版、画面
Output
一张能被指认的稿
你能说「就是它」的东西
Source
一张能看的稿
但它还只是个画面
System 02
翻译成跑得起来的
前端 + 接口 + 数据 + 部署
Output
一个能打开的链接
或者一条能重跑的流水线
Two translation layers · 两套翻译层
掉信息最多的地方不在两套系统内部,在两套系统之间。设计师交给前端一次、前端交给后端一次、后端交给运维一次,每次交接都得把脑子里的东西再说一遍。所以我宁愿自己走完这一段。
One chain · 一条链,六道工序
走完整条链的好处不是省钱,是敢改。放到一半觉得不对,还能退回去重来;要是每一步都包给别人,改一次就是一次预算会。
四条判据 / 越晚改越贵
做设计的人最容易停在同一个地方:「我觉得这版挺好看的」。我也这么停过。后来才认,好看只是及格线——真正的判据是这东西能不能被人拿去用,用坏了还能不能修。
所以我给自己定了四条判据。一条过不了,就还没做完。
它能不能自己跑?
坏了谁修?还找得到原因吗?
成本是多少?算力、订阅、时间。
下次能不能复用?
第一条最容易被忽略。很多东西「做好了」,但其实吊在我身上——我不盯就不动。那不叫交付,那叫托管。能自己跑起来,才轮到谈好不好看。
工具 / 门槛 / 真伪
这几年从设计往 AI 里挪,有三件事我越想越确定。它们不影响我接什么活,但影响我怎么做。
会用 Stable Diffusion 的人在变多,知道什么时候该用它、什么时候该老老实实手绘的人在变少。工具的门槛一直在降,判断的门槛没降——因为它靠的是做砸过的次数。
所以我花在「试错」上的时间比花在「学工具」上的多。
以前要一个团队才能跑的事——搭服务、调模型、出成套素材——现在一张显卡加一个周末能跑通。这不是「一个人顶一个团队」,是「一个人终于能把自己的想法做完」。
所以我坚持本地部署,能自己跑的不租。
换脸、拟声、生成画面越容易,能被验证的原始素材就越值钱。我碰这块技术,但只在授权与合规的场景里碰——本人同意的数字人、影视预演、去标识化测试。这条线不是道德洁癖,是这门手艺能不能长期做下去的前提。
所以我能做,也明确知道哪部分不做。
六道台阶 / 一步推着一步
Stage 01 · 平面
判断标准全在眼睛:这东西看着顺不顺。那时候以为设计就是解决「好不好看」。
Stage 02 · 界面
开始要想点击之后发生什么。第一次意识到:好看的东西不一定好用,好用的东西常常不好看。
Stage 03 · 代码
先是把稿子变成浏览器里真能打开的东西。后来发现光有前端不够——数据存哪儿、接口给谁调、服务器上怎么跑起来,都得自己接上。
Stage 04 · 影像
学会了怎么在很短的时长里把一件事讲完。这个能力后来全用在别处——讲方案、写页面、做演示。
Stage 05 · 模型
Stable Diffusion 的 WebUI 先跑通,后来转到 ComfyUI,把流程拆成节点。拆开之后才明白,出图不是抽奖,是可调的系统。
Stage 06 · 现在
底层是 LLM、开源模型本地部署、深度伪造;往上走,落点全在办公与商业场景:一个人一天干不完的活被压成几分钟,要人盯着点的流程交给 Agent 自己跑,只在脑子里的判断被写成能被调用的 Skill。
回头看,这六步不是规划出来的,是每次卡住就往前挪一格:稿子交出去改不动,就去学写代码;页面做出来跑不起来,就去补后端;做出来没人看,就去学拍片;素材做不完,就去学模型。每一步都不是为了「多一个技能」,是为了别在下一次卡住的时候只能等别人。
一个人, 和他的一队 Agent。
能做的活儿会越来越便宜,
能被信任的人会越来越贵。
我也先拿自己试:把设计、开发、影像、模型这四块的经验和工作方式,慢慢沉淀成一个能跟着我一起长的知识分身。域名先占着,网站慢慢搭,分身也还在造。
会在这里写下我在 AI 内容生产里的实践:Stable Diffusion 的工作流怎么搭、ComfyUI 的节点怎么连、开源模型怎么在本地跑起来、一个页面怎么从稿到上线。
还是喜欢跟真正动手做事的人交朋友。如果你也在用 AI 干活,或者在设计、前端、影像、模型这几块里折腾,特别想认识你。
Character
Agent 制造员 · 驾驶者